商业秘密保护,已经成为AI领域的监管重点。
2026年8月27日,北京市市场监督管理局公布了北京首例AIGC领域商业秘密行政处罚案:一名员工把原单位自主研发的AIGC软件和配套数据库带到新公司使用,最终被罚款10万元。这个案件说明,监管关注的不只是AI生成了什么,也包括AI软件、数据等数字资产如何被取得和使用。
不过,这起案件的侵权结构仍然很传统。把AIGC软件换成配方、图纸、客户名单或者源代码,它仍然是一宗典型的携密跳槽案件。AI是被侵犯的资产,却没有改变问题本身。
在律师行业,AI时代更难处理的商业秘密问题,可能发生在另一种场景里:没有人离职,没有人把文件带到另一家公司,客户的材料却在不知情的情况下,被逐渐转化成了律所自己的AI能力。
NO.01 AI要真正参与办案,就必须读到卷宗
首先,我不赞成因为存在保密风险,就笼统地要求律师不得向AI输入案件材料。
在诉讼业务中,如果只告诉AI一个抽象案由,或者把事实删得只剩下几句话,它通常只能给出正确但无用的答案。AI需要看到相对完整的合同、往来文件、聊天记录、证据缺口和诉讼动作,再由律师判断哪些分析成立、哪些风险需要回应,才可能真正参与诉讼策略。
因此,问题不能被简化成“能不能把卷宗交给AI”。更准确的区分在于,AI此次读取材料只是为了办理当前案件,还是会让律所的系统今后继续利用这些材料。
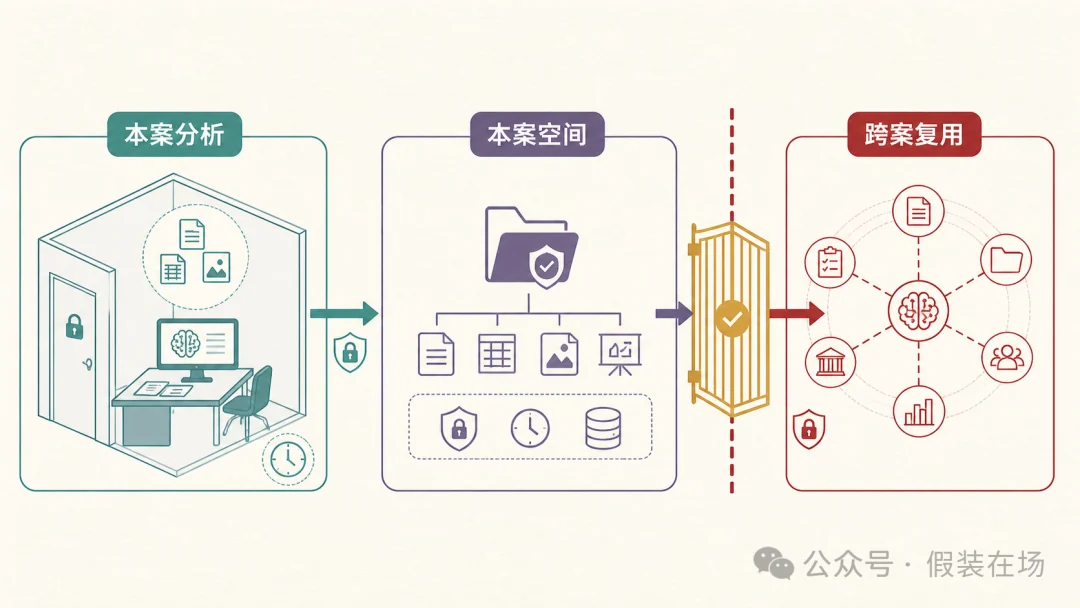
01本案内分析
在当前案件空间中读取、分析和生成结果
限本案团队使用,不进入模型训练,不被其他案件检索
02本案知识空间
在案件办理期间持续保存事实、证据和工作成果
权限、保存期限和删除规则与案件绑定
03律所级知识沉淀
写入跨案件知识库,或者用于模型微调、蒸馏和评测
需要另外判断授权、抽象程度、来源和不利使用风险
技术上使用的是大模型、RAG知识库还是其他系统,并非判断重点。只需看未来办理另一个案件的人,能否从这次上传中获得原本无法取得的知识。如果答案是能,律所就已经从“使用工具办理本案”,走到了“利用办案材料建设自己的能力”。客户把材料交给律所,是为了办理当前委托;律所能否改变取得材料时的用途,把本案信息转化成服务其他案件的能力,需要单独回答。
NO.02 把客户名称删掉,并不能回答全部问题
讨论AI保密时,最常见的办法是脱敏。姓名、公司名称、地址和联系方式被删除以后,很多人会觉得材料已经安全。
《个人信息保护法》所说的个人信息,围绕“已识别或者可识别的自然人”展开,匿名化确实会影响个人信息规则的适用。但是,公司能不能被识别,并不是个人信息保护法要解决的全部问题。客户的交易结构、成本数据、谈判底价、技术方案和证据缺口,即使不再显示公司名称,仍可能属于未公开且具有商业价值的信息。
现行《反不正当竞争法》第十条规定的商业秘密,包括不为公众所知悉、具有商业价值并经权利人采取相应保密措施的技术信息、经营信息等商业信息。最高人民法院的相关司法解释还列举了算法、数据、计算机程序及其文档等技术信息。北京首案正是这套规则在AIGC软件上的一次具体适用。
商业秘密侵权也不以“向公众泄露”为唯一形态。违反保密义务或者权利人的保密要求,擅自使用所掌握的商业秘密,本身就可能进入法律评价。无法从最终输出中认出原客户,不能自动倒推出最初的使用已经获得授权。
但商业秘密只是其中一层。并非所有客户材料都满足秘密性、商业价值和保密措施等条件,也不能因为材料不构成商业秘密,就认定律所可以自由使用。《律师法》第三十八条除了商业秘密和当事人隐私,还要求律师对执业中知悉的、委托人和其他人不愿泄露的有关情况和信息予以保密。这里其实有三个不同的问题:信息是否构成商业秘密,律师是否负有职业上的保密义务,律所取得材料时被允许使用到什么范围。三者可能重合,却不能相互替代。
美国乔治城大学法学院教授Jonah Perlin长期研究法律职业伦理与法律科技。他认为需要把律师保密责任拆成保守秘密、保障安全和忠于客户利益三个层面,对应披露、访问和冲突风险。这套区分提醒我们,没有对外泄露,不代表内部访问和利益冲突已经得到解决。
NO.03 律师当然可以积累经验,但AI会把经验的边界重新放大
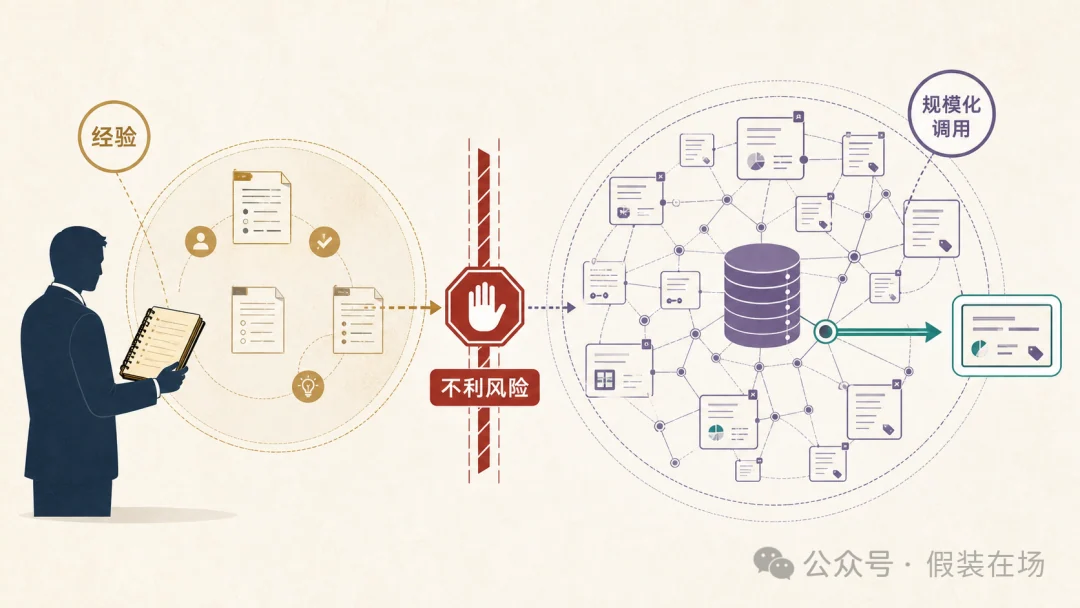
一个有力的反对意见是,律师办案本来就会积累经验。如果AI一概不能学习,律所的知识管理也会被一并阻断。这个质疑有道理,律师从多个案件中总结举证经验、合同审查方法和工作清单,都可以成为专业能力,客户也不能要求律师在结案后忘记全部经历。
AI带来的变化在于,系统可以长期保存极其具体的事实组合,可以跨越不同团队自动检索,还可以在使用者不知道来源的情况下,把一个客户的证据缺口带进另一个客户的诉讼策略。这种规模、速度和隐蔽性,已经超过了律师对一般经验的自然记忆。
因此,边界不宜简单画在“人可以学、机器不能学”,也不宜只看材料是否删除了名称。至少要依次经过三道判断:知识从哪里来,原本被允许用于什么;经过处理后,是否仍然保留或者可以还原客户特有的信息;新的调用是否会造成利益冲突或者可以合理预见的实质不利。
如果客户已经明确要求材料不得用于模型训练、跨案件知识库或者其他案件,律所作出承诺后就应当遵守。如果合同没有约定,抽象的法律判断、审查方法和工作流程,并不当然属于客户专有;但仍然保留客户独有交易安排、未公开策略或者证据缺口的所谓“经验”,不应进入可以自由调用的律所级知识库。
风险审查也不能等到客户已经受损。商业秘密被用于谈判或诉讼以后,很难恢复原状;客户又几乎不可能证明,对方的优势究竟来自哪一次系统调用。接案冲突审查解决的是律所能不能接受一个新客户,AI知识库还要在调用时判断,当前案件有没有资格使用某项来自旧案件的知识。
NO.04 Harvey真正给我的启发,不是“法律AI有多强”
Harvey是一家总部位于美国、面向律所和企业法务的法律AI公司,可以简单理解为法律团队的AI工作台。我最近看Harvey创始人的相关分享时,原本关注的是法律AI如何形成专业能力,后来发现,它公开披露的数据路径更值得律师行业认真看。
按照Harvey官网的说明,其合同禁止模型提供商使用客户数据训练模型,Harvey也只为处理客户请求而使用这些数据,不将其用于模型改进。但“不用于训练”不等于“不处理”,AI为了回答当前案件的问题,仍然需要读取和分析材料。真正需要追问的是,这些处理是否被限制在当前客户和当前案件之内。
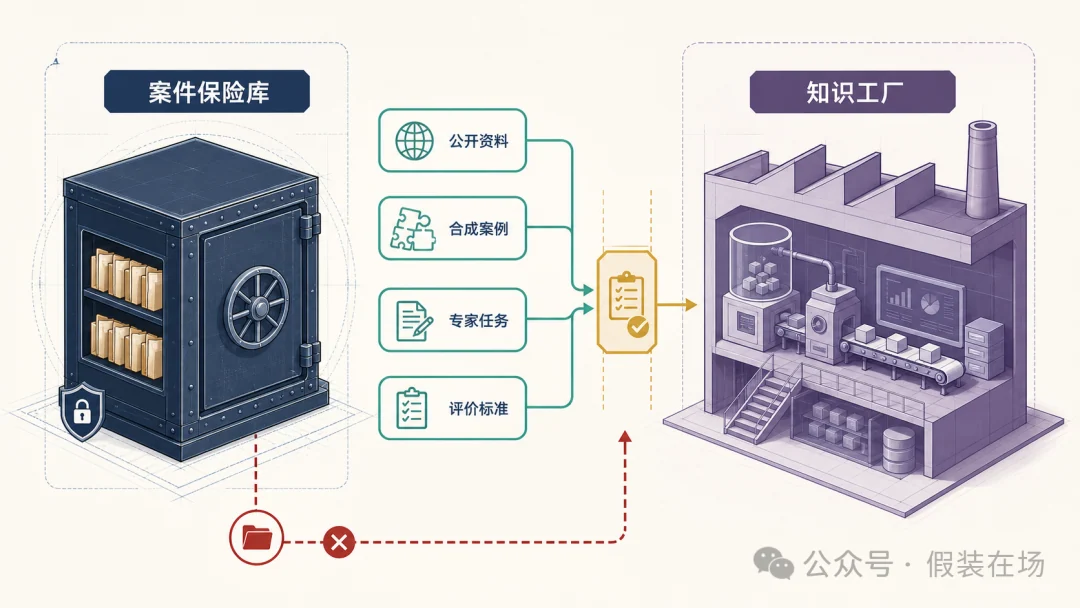
Harvey的后训练项目,使用的是合成数据、公开法律数据和人类专家数据。它还构建了一家虚拟律所,生成近一万份合同、邮件和办案文件,让AI从中寻找类似案件、识别客户习惯、总结行业趋势。这解决了测试问题,却没有解决真实律所的知识来源问题:模型训练和公开测试可以更多依靠公开或合成数据,真实案件仍要进入受控的案件空间,跨案件沉淀则要另外经过授权、抽象和冲突审查。
Harvey可以承诺平台如何处理律所上传的数据,却无法替律所回答是否已经取得客户授权。平台与律所之间的数据安排,不能代替律师与客户之间的保密义务。
律所内部可以分成两个空间:一个是案件保险库,保存客户交付的原始材料和本案策略;另一个是知识工厂,把经过审查的办案经验转化成模板、规则、评价标准和工作流程。两个空间之间应当有一道门。原始卷宗不能因为技术上可以导入,就自动进入知识工厂。
NO.05 合同与系统,缺一不可
如果律所要求律师额外整理、上传和填报,再去另一个入口调用AI,律师很容易回到更方便的个人工具。合规路径必须是效率最高的路径:案件材料通过标准办案流程进入受控空间,律师在其中获得更完整的AI能力,不必重复上传和交代背景。统一系统不能消灭故意绕行,却可以让绕行从无法分辨的日常操作,变成能够识别和归责的违规行为。
美国圣路易斯大学法学院教授Carol A. Needham长期研究法律伦理与职业责任。她在一篇讨论法律服务使用生成式AI的论文中指出,普通律师很难取得供应商的算法和系统运行信息,无法独自完成全面核查,因此律所必须在供应商选择、系统权限和统一审计上承担组织责任。
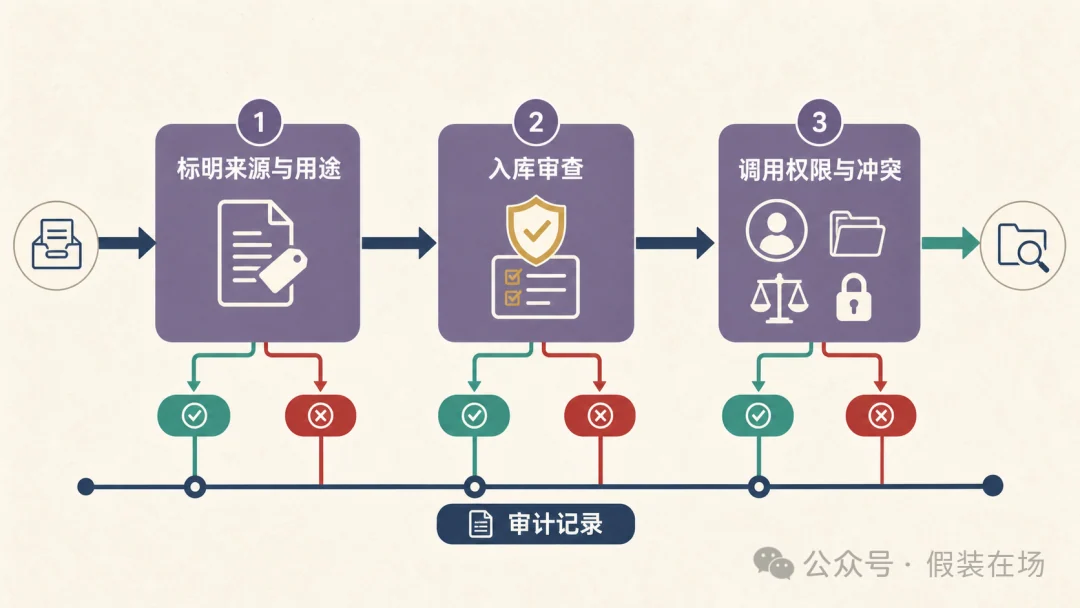
在此基础上,至少还需要三层控制。
一是给知识标明来源和用途。每项可能进入律所知识库的内容,都应当能够说明它来自公开资料、合成数据、律师独立编写,还是某个具体案件;允许本案使用、内部研究还是跨案件复用,也应当一并记录。
二是把“从案件到知识库”变成一次真正的审查。原始卷宗、客户特有事实和未公开策略默认留在案件空间;律师重新抽象形成的审查规则、评价标准和工作流程,经过来源、授权及不利使用风险检查后,才能进入律所级知识库。
三是在调用时继续做权限和冲突判断。系统除了回答“我能否找到这项知识”,还要回答“当前用户和当前案件是否有权使用它”。调用记录应当可以审计,异常的跨案件访问能够被发现。
目前很多律师委托合同对AI使用保持沉默,沉默不应被直接理解为客户已经同意律所把材料用于跨案件知识沉淀。律所知道数据是否留存、能否被其他案件调用,客户却很难获得这些信息;知识库建成后的收益主要归律所,泄密或者不利使用的风险却由原客户承担。因此,把默认状态设为“不允许跨案件沉淀”更为合理,由掌握信息的律所主动说明真实用途。这是一项内部治理建议,不意味着现行法律已经为所有AI使用规定了统一的同意形式。
提前告知不意味着每次调用AI都要让客户点击一次同意。更合适的做法,是在委托开始时把两类行为分开说明:律所是否会使用经过批准的AI工具办理本案,数据采取哪些隔离和不训练措施;客户材料是否可能被用于跨案件知识库、模型优化或者其他能力建设。第二类使用不应藏在一句笼统的“客户同意律所使用人工智能工具”里。
美国律师协会第512号正式意见虽然不适用于中国,但其区分值得参考:当自学习工具可能让一个客户的信息影响其他用户或其他案件时,需要知情同意,笼统的格式条款并不足够。
客户授权也不是万能通行证。材料中可能包含第三人的秘密和个人信息,跨案件调用还可能触发利益冲突,授权只是审查的一部分。
合同负责说明用途和稳定预期,系统负责日常执行和事后证明。上海市律师协会2026年发布的试行指引,已经提出使用AI前对客户身份、交易信息、商业秘密、争议事实和核心证据进行必要脱敏,并要求未经授权或安全评估,不应向公共AI平台上传敏感信息。这是现实起点,律所内部AI还需要继续回答跨案件沉淀的问题。
NO.06 AI时代的商业秘密保护,要管理“知识如何变成能力”
北京首案留下了一条清楚的证据链:“拷贝—破解—跨公司复用—持续获利”。它针对的是已经发生的数字资产窃取。
律所AI需要建立另一条可以被管理和审计的链条:“来源—授权—转换—调用”。每一项进入系统的知识,都应当知道从哪里来;每一次从案件材料到律所知识能力的转换,都应当有明确边界;每一次跨案件调用,都要能够判断会不会损害原客户。
日志的价值不只在于内部管理。客户对材料的去向提出疑问时,律所还应当有能力说明材料如何被处理和调用。
一家律所的AI越来越聪明时,它应当能够回答的不只是法律问题,还包括三个更基础的问题:这项知识从哪里来,原本被允许用于什么,我现在的调用是否已经越过边界?
参考资料
1. 北京市市场监督管理局:《全市首例AIGC领域商业秘密行政处罚案开出10万元罚单》
2. Jonah Perlin:Client Confidentiality and Generative AI
3. Harvey:数据安全说明、Harvey Tenet后训练项目、LAB模拟律所知识评测
4. Carol A. Needham:Regulation of the Use of Generative Artificial Intelligence Tools in the Delivery of Legal Services: Verification and Accountability
5. American Bar Association:Formal Opinion 512
6. 上海市律师协会:《律师企业法律顾问服务AI应用操作指引(2026)(试行)》